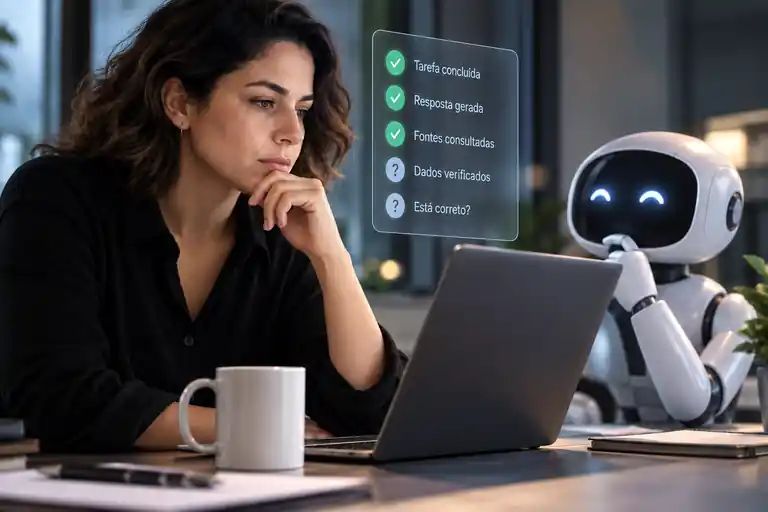
Você pede a uma inteligência artificial que resuma um documento. O texto parece ótimo. Pede que ela analise uma planilha. A resposta parece convincente. Um sistema consulta informações, compara alternativas, executa algumas etapas e informa que concluiu a tarefa.
Tudo parece ter funcionado. Mas como você sabe?
Durante boa parte da popularização recente da inteligência artificial generativa, a atenção esteve concentrada na capacidade dos modelos: qual escreve melhor, qual raciocina melhor, qual programa melhor. À medida que esses sistemas entram em atividades reais, porém, essa pergunta começa a ser insuficiente. A questão deixa de ser apenas “o que esta IA consegue fazer?” e passa a incluir outra, mais difícil: “como sabemos que ela fez corretamente?”
Uma resposta convincente não é necessariamente uma resposta correta
Um modelo de linguagem pode produzir um texto claro, bem estruturado e plausível sem que todas as informações presentes nele estejam corretas. Fluência e factualidade são propriedades diferentes. Por isso, uma avaliação baseada apenas na impressão de quem lê pode ser enganosa.
Um resumo pode parecer excelente e ter omitido justamente a informação mais importante do documento. Uma análise financeira pode apresentar cálculos corretos, mas usar uma premissa inadequada. Uma resposta sobre uma política interna pode estar bem escrita e, ainda assim, usar uma versão desatualizada da fonte.
O problema fica maior quando a IA começa a agir
Há uma diferença importante entre uma IA que responde a uma pergunta e um sistema que executa uma sequência de ações. Agentes de IA podem consultar fontes, usar ferramentas, interagir com sistemas, tomar decisões intermediárias e realizar várias etapas até alcançar um objetivo.
Nesse cenário, avaliar apenas a resposta final pode esconder o que aconteceu durante o processo. Um agente pode chegar ao resultado correto usando a fonte errada, executar dez etapas quando seriam necessárias três, funcionar em um teste e falhar diante de uma pequena variação da mesma solicitação.
Uma revisão sistemática publicada em setembro de 2026 na Artificial Intelligence Review analisou 259 estudos sobre avaliação de agentes baseados em grandes modelos de linguagem. O trabalho chama atenção para um ponto essencial: números de benchmarks não se interpretam sozinhos. Seu significado depende da capacidade que está sendo medida, da forma de pontuação e do ambiente no qual o agente é testado.
92% de acerto pode ser excelente. Ou péssimo.
Suponha que um sistema de IA tenha 92% de acerto. Parece um ótimo resultado, mas ainda falta informação. Acerto fazendo o quê? Classificando fotografias? Identificando transações suspeitas? Respondendo clientes? Autorizando pagamentos? Os mesmos 8% de erro podem ter consequências completamente diferentes dependendo da tarefa.
Também importa saber quais são esses erros. Se eles estão distribuídos em casos pouco relevantes, temos um cenário. Se o sistema apresenta boa média geral, mas falha justamente nas situações críticas, temos outro. Avaliar IA, portanto, não significa procurar um único número capaz de representar toda a qualidade do sistema. Significa definir o que importa naquela aplicação.
Um benchmark não é o mundo real
Benchmarks são conjuntos de testes usados para comparar modelos e sistemas. Eles são úteis. O problema começa quando uma pontuação é transformada em uma declaração universal de qualidade.
Outra revisão publicada em 2026 examinou 15 benchmarks amplamente utilizados para agentes e encontrou uma distância relevante entre o que muitos testes medem e o que importa na implantação. No conjunto analisado, segurança e proteção contra abusos não apareciam na pontuação principal, custo também não fazia parte da avaliação primária e a maior parte dos benchmarks se concentrava em sucesso ou falha da tarefa.
Um sistema pode, portanto, apresentar resultados impressionantes em testes padronizados e ainda ser inadequado para determinada organização. O benchmark mede uma capacidade sob condições definidas. A aplicação real precisa avaliar um sistema dentro de um contexto.
E as empresas já estão descobrindo isso
Essa diferença entre teste e operação não é apenas teórica. Um estudo sobre agentes utilizados em produção reuniu respostas de 306 profissionais e realizou 20 estudos de caso em 26 domínios. A confiabilidade apareceu como o principal desafio de desenvolvimento e 74% dos participantes disseram depender principalmente de avaliação humana para seus agentes.
Há uma razão para isso. Em tarefas reais, frequentemente não existe apenas uma resposta correta. Um relatório, por exemplo, pode precisar estar factualmente correto, cobrir determinados assuntos, obedecer a um formato, usar somente fontes autorizadas, evitar informações confidenciais e ainda ser produzido dentro de limites de custo e tempo. “Gerou o relatório” é apenas uma parte da avaliação.
Antes de medir, defina o que significa funcionar
Não existe boa avaliação sem critério. Antes de perguntar se uma IA funciona, precisamos definir o que “funcionar” significa naquele contexto. Para uma aplicação, o principal critério pode ser precisão. Em outra, pode ser a capacidade de fundamentar cada informação em uma fonte. Também podem importar consistência, tempo de execução, custo, segurança, taxa de erro, capacidade de lidar com exceções e necessidade de intervenção humana.
A avaliação nasce da tarefa, não do modelo. Essa inversão é importante porque muitas discussões sobre IA ainda começam pela tecnologia: primeiro escolhemos uma ferramenta e depois procuramos onde utilizá-la. Em aplicações reais, faz mais sentido entender o problema, definir o resultado esperado e os critérios de qualidade e, somente então, avaliar se determinada tecnologia atende a eles.
Nem toda avaliação precisa ser complicada
Uma pequena empresa que utiliza IA para responder clientes pode montar um conjunto de perguntas reais e definir quais informações obrigatoriamente devem aparecer nas respostas. Uma equipe que usa IA para resumir contratos pode comparar os resumos com documentos previamente revisados. Um sistema que consulta uma base de conhecimento pode ser testado não apenas pela resposta produzida, mas também pela fonte usada para produzi-la.
Com o tempo, exemplos reais de sucesso e falha podem formar um conjunto de testes próprio. Isso é muito mais informativo do que simplesmente perguntar se “a resposta parece boa”.
Avaliação não é o último passo
Modelos mudam. Dados mudam. Documentos são atualizados. Sistemas externos são alterados. Novas situações aparecem. Uma aplicação que funcionava corretamente pode apresentar comportamento diferente depois de uma atualização de modelo, de uma mudança na fonte de dados ou de uma alteração no fluxo de trabalho.
Por isso, avaliar deixa de ser apenas uma prova aplicada depois que o sistema está pronto e passa a fazer parte da própria operação. O tema ganhou também dimensão econômica: em setembro de 2026, Anthropic e Accenture anunciaram uma parceria para ampliar avaliação, testes adversariais e análise de salvaguardas de modelos. Cada empresa afirmou esperar investir pelo menos US$ 1 bilhão nos próximos cinco anos nessa capacidade.
A pergunta que vem depois do encantamento
Durante algum tempo, bastava mostrar uma inteligência artificial produzindo um texto, uma imagem ou algumas linhas de código para provocar surpresa. Essa fase está ficando para trás. A IA está entrando em processos reais, e processos reais exigem critérios.
Não basta que uma resposta seja impressionante. Não basta que um agente termine uma tarefa. Não basta que um modelo esteja no topo de um ranking. Precisamos saber o que foi medido, como foi medido e se aquilo que foi medido corresponde ao problema que realmente queremos resolver.
Depois de perguntar durante anos “o que a IA consegue fazer?”, começamos finalmente a fazer uma pergunta melhor: “como sabemos que ela fez bem?”
Fontes e referências
- Artificial Intelligence Review — Large language model agent evaluation and benchmarking (15 set. 2026) ↗
- Artificial Intelligence Review — From benchmarks to deployment: a comprehensive review of agentic AI evaluation (24 abr. 2026) ↗
- Measuring Agents in Production — estudo com profissionais e casos de uso (2025) ↗
- Anthropic — Partnering with Accenture on embedded evaluation (18 set. 2026) ↗